Weight Space Programming: Quando Modelos de IA Podem Ler e Escrever os Próprios Pesos
Weight Space Programming: Quando Modelos de IA Podem Ler e Escrever os Próprios Pesos
Uma das descobertas mais interessantes na investigação em inteligência artificial deste ano poderá mudar a forma como compreendemos e desenvolvemos estes sistemas. Investigadores do MIT demonstraram que modelos avançados como o GPT-6 Astra conseguem interpretar os pesos de outras redes neuronais e, em determinadas circunstâncias, modificá-los diretamente e em tempo real. Esta abordagem, denominada Weight-Space Programming, abre novas possibilidades tanto para compreender o funcionamento interno da IA como para melhorar o desempenho de modelos existentes. Até agora, grande parte deste processo permanecia uma espécie de caixa negra (para ser suave na descrição).

Para perceber a importância desta descoberta, importa compreender que uma rede neuronal é constituída por milhões ou milhares de milhões de parâmetros, conhecidos como pesos (weights). Estes valores determinam a forma como a informação é processada e como o modelo produz as suas respostas. Tradicionalmente, os pesos são ajustados através de algoritmos de otimização, como o gradient descent. A novidade é que um modelo de linguagem pode agora analisar estes valores diretamente, identificar padrões e modificar partes específicas da rede sem recorrer ao processo convencional de treino. Sim.. leu bem.. é isso mesmo!

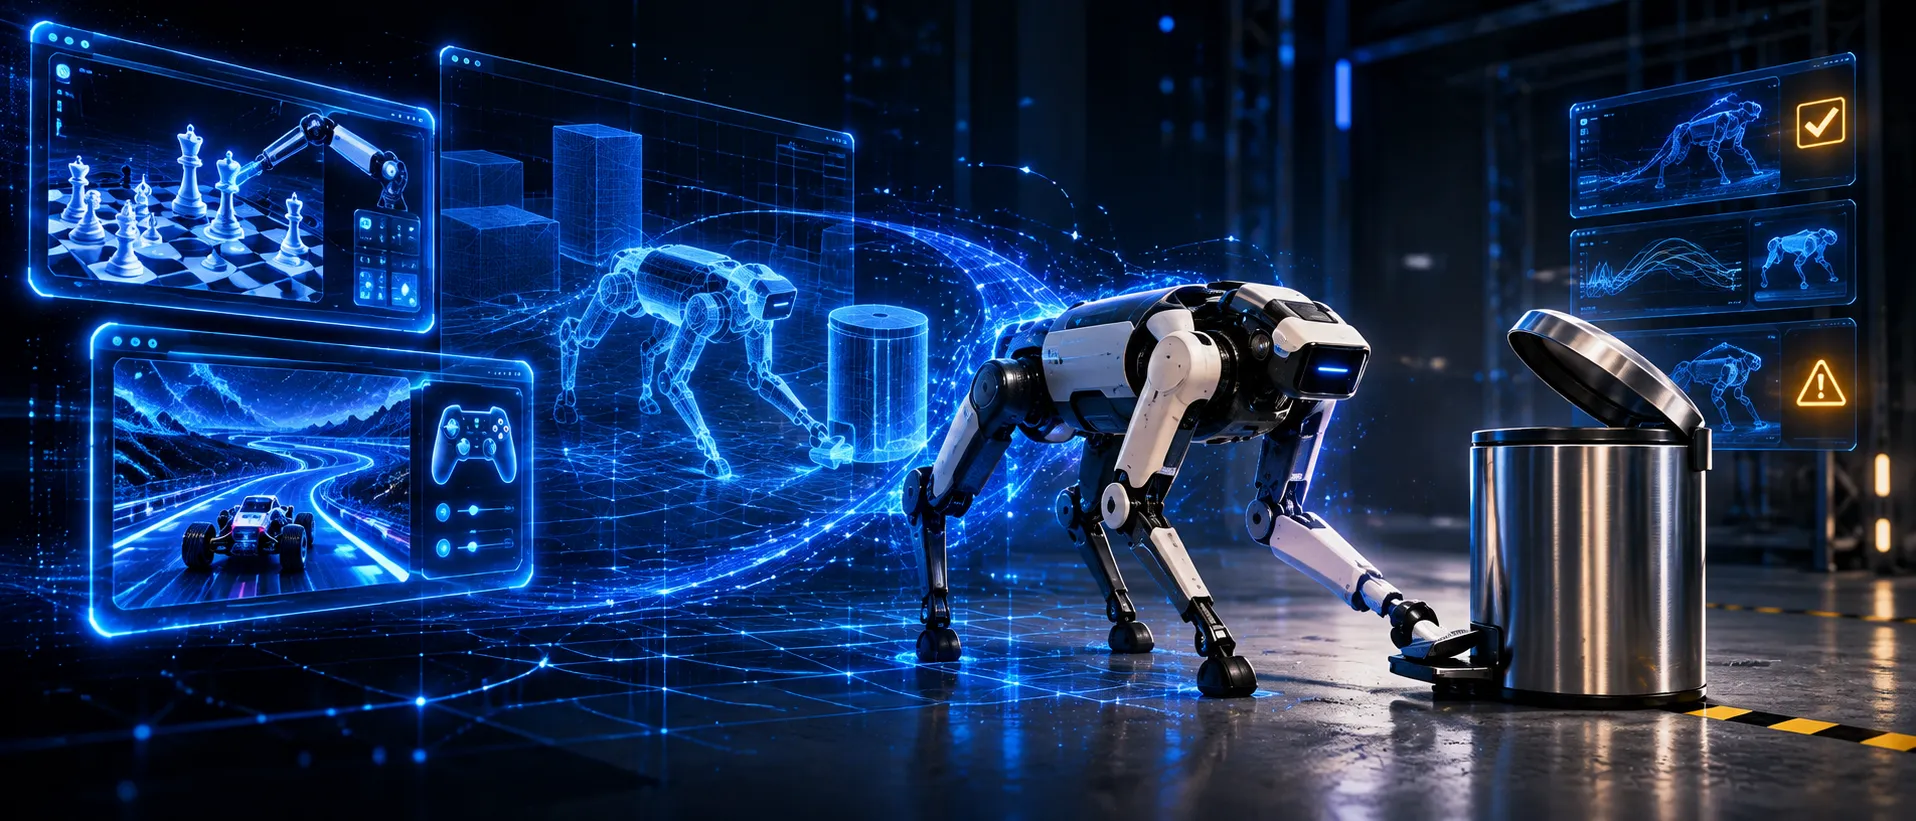
Nos primeiros testes, o Astra conseguiu identificar corretamente o comportamento de várias redes neuronais apenas através dos seus pesos. Foi capaz de determinar que objetos diferentes estavam a ser executados por determinadas redes, identificar formas produzidas por modelos de difusão e reconhecer características de modelos linguísticos treinados em diferentes idiomas. Mas mais impressionante ainda, conseguiu corrigir uma rede de controlo automóvel que falhava sistematicamente, alterando apenas 3,5% dos seus pesos e obtendo sucesso em 1024 simulações consecutivas.
Mas e se tentarmos melhorar um modelo mais pequeno? Sim.. foi mesmo isso que os investigadores pensaram, e se bem que o pensaram... melhor o fizeram! Assim sendo, um dos resultados mais surpreendentes surgiu quando os investigadores utilizaram o Astra para melhorar o Qwen3.5-0.8B, um modelo de linguagem relativamente pequeno. O Astra identificou uma falha que provocava ciclos intermináveis de raciocínio e corrigiu-a modificando apenas 0,016% dos parâmetros. Nos testes apresentados, a pontuação no benchmark matemático MATH-500 aumentou de 7,9% para 48,1%, enquanto o desempenho no GSM8K subiu de 13,8% para 67,1%. Importa salientar que esta intervenção não ensinou matemática ao modelo.. simplesmente eliminou um problema que o impedia de utilizar eficazmente capacidades que já possuía. Yep... 0.016%... dá que pensar não dá?
Na minha opinião, estamos perante uma linha de investigação com implicações potencialmente enormes (e estou a ser cauteloso naquilo que falo). Se modelos avançados conseguirem compreender melhor os pesos de outras redes, poderemos desenvolver ferramentas de diagnóstico, correção, melhoria e otimização muito mais rápidas e precisas. No futuro, isto poderá contribuir para sistemas parcialmente autoaperfeiçoáveis, modelos especializados em tarefas concretas e uma compreensão mais profunda dos mecanismos internos da inteligência artificial. Contudo, como sempre.. temos de ter em atenção que estes resultados são ainda preliminares, não demonstram autoaperfeiçoamento autónomo nem substituem os métodos tradicionais de treino.. por enquanto! O potencial é extraordinário, mas ainda estamos no início... (e se isto é apenas o início... bom... o resto fica à sua imaginação!)