Ornith-1.5: o modelo que cria o próprio currículo, mas ainda tem de provar serviço
Ornith-1.5: o modelo que cria o próprio currículo, mas ainda tem de provar serviço
O Ornith-1.5 chega com uma promessa que merece alguma atenção (ou muita), pois em vez de depender apenas de tarefas preparadas por humanos, o modelo participa na construção do seu próprio processo de aprendizagem. Gera problemas, define a estrutura necessária para os atacar e produz tentativas de resolução que alimentam o treino por reforço. É uma ideia ambiciosa (e assustadora), mas não deve ser confundida com uma máquina que continua a aprender sozinha depois de instalada (pelo menos por enquanto).

A família tem três escalas: um modelo denso de 9 mil milhões de parâmetros, uma versão mixture-of-experts de 35B-A3B e o modelo de topo, também MoE, com 397 mil milhões de parâmetros. A gama está disponível em pesos abertos e inclui variantes GGUF, FP8, NVFP4 e MLX, o que abre portas tanto a experiências locais como a infra-estruturas de maior dimensão.
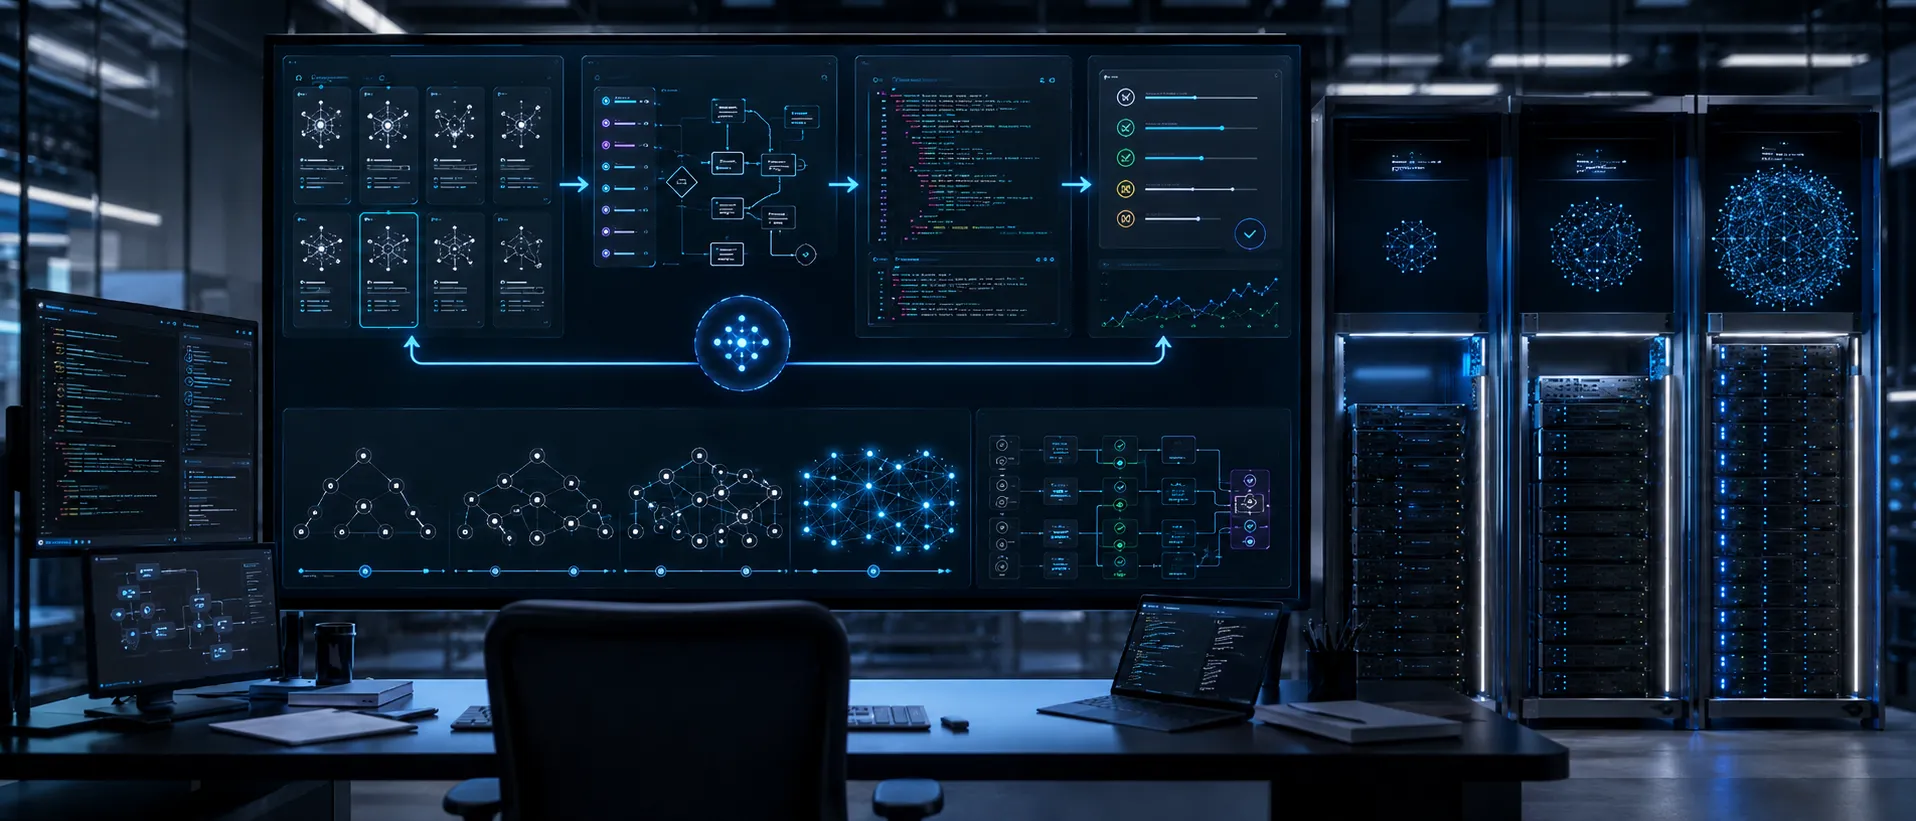
Um ponto técnico de interesse está no seu ciclo de treino. O sistema procura tarefas válidas, verificáveis e suficientemente difíceis para exporem falhas do modelo sem se tornarem impossíveis. Depois cria ou ajusta uma scaffold específica (instruções, ferramentas, decomposição e orquestração) antes de gerar soluções. A recompensa volta às três fases: criação da tarefa, construção da scaffold e execução.
Na prática, isto é uma forma de currículo adaptativo. Quando uma tarefa se torna fácil, deixa de ser particularmente útil para o treino; o gerador é empurrado para problemas mais exigentes. A Ornith também inclui um sinal de novidade para evitar que o sistema se limite a repetir variações da mesma questão. A eficácia desta abordagem depende, porém, da qualidade dos avaliadores: uma tarefa mal definida ou uma recompensa manipulável degrada o processo inteiro.

Os números divulgados são fortes. No seu quadro de avaliação, o Ornith-1.5-397B obtém 86,1 no Terminal-Bench 2.1 e 56,0 no DeepSWE. A versão 35B-A3B apresenta 68,5 no Terminal-Bench 2.1 usando Claude Code e 79,0 no SWE-bench Verified. Já o modelo de 9B obtém 47,0 e 70,6 nesses mesmos testes. São resultados competitivos, sobretudo para a variante intermédia, que activa cerca de 3B de parâmetros por token.
Mas há que ler estes resultados com alguma disciplina. Eles foram publicados pela própria equipa e dependem de configurações concretas: harnesses, modelos avaliadores, janelas de contexto, amostragem, limites de tempo e medidas contra reward hacking. A documentação indica médias de cinco execuções para os resultados do Ornith, mas não foram encontradas reproduções independentes dos valores de destaque durante esta verificação... portanto, vamos assumir isto com alguma cautela!
Também não há uma vitória universal... é que no próprio quadro do projecto, o Ornith-1.5-397B fica abaixo de alguns concorrentes em determinadas provas, incluindo DeepSWE e vários testes de raciocínio ou agentes. Isso não diminui o interesse do lançamento, apenas impede a leitura simplista de que um único modelo passou a dominar tudo. Já a versão de 35B-A3B parece ser a candidata mais pragmática para equipas técnicas. Ela promete comportamento de agente e utilização de ferramentas sem exigir imediatamente a infraestrutura do modelo de 397B. Ainda assim, o ganho de eficiência por token não elimina o custo de armazenar, servir e manter um modelo desta dimensão, sobretudo quando se pretende contexto longo e concorrência aceitável.
Do outro lado, temos o 9B. Aqui há variantes quantizadas e formatos orientados para execução local, incluindo integrações com Ollama, llama.cpp e MLX. A disponibilidade não equivale, por si só, a uma recomendação para produção: uma versão quantizada deve ser validada separadamente, porque não se pode assumir que preserva o comportamento dos resultados obtidos em BF16 ou noutro formato de referência como é evidente.
Para trabalho com código, a melhor abordagem será talvez fixar a revisão exacta do checkpoint, preparar um conjunto de tarefas internas já conhecidas, repetir cada uma várias vezes e medir qualidade dos patches, chamadas de ferramentas inválidas, alterações desnecessárias, recuperação após erro e tempo de revisão humana. Um agente que resolve uma demonstração e estraga dois repositórios não é de todo um bom negócio... nope!
Há pois curiosidade sobre até onde o pós-treino e a scaffold explicam o salto de desempenho, mas também perguntas legítimas sobre a origem dos modelos-base e a reprodução dos benchmarks. Penso que seja uma reação saudável... pois os pesos abertos facilitam adopção e escrutínio mas não substituem validação independente. Por agora, merece uma avaliação séria, não fé cega...