NCM: Quando a memória não é o gargalo
NCM: Quando a memória não é o gargalo
O hype em torno do novo modelo NCM da Stanford e Together AI tem sido inevitável, e confesso que, assim como muitos, o primeiro impulso foi de ceticismo reacionário. Quando li os títulos sobre um modelo que poderia escrever 1.024 tokens em apenas 32 passagens (uma redução de 32x) o instinto de "pois claro... mais outro" surgiu, aquela sensação de já ter clicado em promessas maravilhosas que evaporaram na manhã seguinte. Mas desta vez o white paper saiu de Stanford e a "promessa" é diferente, mais sofisticada, embora as manchetes tenham capturado apenas o número e não a nuance científica por trás dele.

Bom.. ao que parece o NCM não funciona como um modelo de linguagem tradicional que gera um token de cada vez, puxando o modelo da memória repetidamente. Em vez disso, ele opera mais como um modelo de difusão de imagem, ou seja, começa com um esboço grosseiro usando poucos códigos de nível superior que definem a forma geral da resposta, e progressivamente adiciona detalhe em camadas inferiores até chegar a um código por token que o decodificador transforma em palavras legíveis. É paralelo em vez de sequencial, e faz todo o sentido para certos tipos de problema onde cada elemento depende de todos os outros, como no Sudoku.
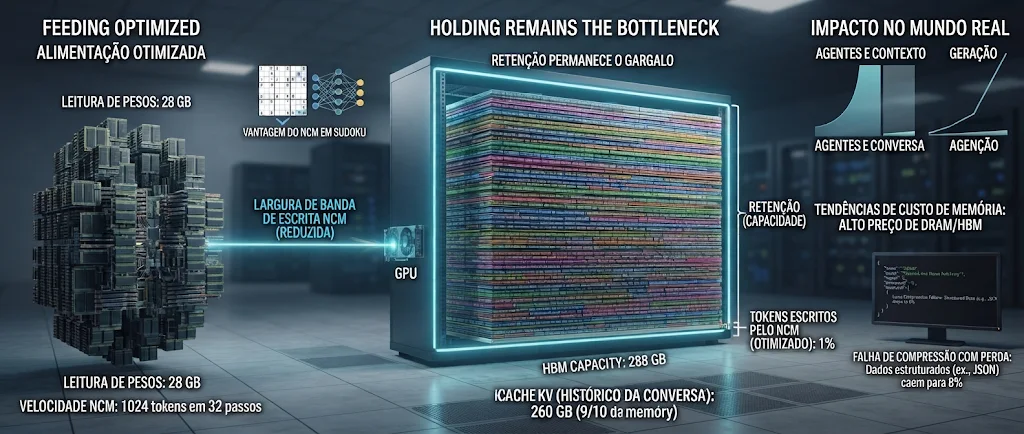
Onde as manchetes falharam estrepitosamente foi na distinção entre "feeding" (alimentação) e "holding" (retenção) da memória de IA. O primeiro refere-se à largura de banda (quantos bytes por segundo a memória pode entregar à unidade de cálculo) e o segundo à capacidade (quantos bytes podem ficar armazenados simultaneamente). O NCM melhora o feeding ao reduzir o número de leituras de pesos do modelo, mas ignora completamente o holding. E é neste ponto que a realidade esmaga a expectativa, pois em servidores modernos, a capacidade já engole a maior parte da memória disponível, deixando a banda larga como problema secundário.
Pegando o Qwen 3.8B com 27,8 bilhões de parâmetros... os pesos do modelo ocupam cerca de 28 GB em precisão de 8 bits, mas o KV cache (a memória de trabalho do modelo para manter o contexto da conversa) para uma conversa de 128K tokens chega a 8,6 GB. Um GPU H100 tem 288 GB de HBM total, mas depois de retirar 28 GB dos pesos, sobram aproximadamente 260 GB, e quase 9/10 daquele espaço são ocupados pelo cache de conversas individuais. Ou seja, o NCM otimiza os cerca de 1% de tokens que o modelo realmente escreve, mas os 99% restantes (o histórico da conversa) continuam ocupando espaço exatamente da mesma forma.
O batching (quando um servidor lê os pesos uma única vez para servir múltiplos usuários simultaneamente) ajuda no nível de infraestrutura, mas... também não resolve o problema fundamental! O KV cache de cada utilizador é privado e inespecífico. Dados da OpenRouter mostram que, em setembro, tokens em cache (aquilo que o modelo já viu e mantém "quente" na memória) representaram quase 90% de tudo o que agentes usaram, enquanto a saída real do modelo (aquilo que o NCM otimiza) foi de apenas 1%. Em janeiro, esse ratio estava em 60%. Os agentes estão a usar sete vezes mais tokens por semana do que humanos, e a grande maioria é contexto, não geração!

As alegações de velocidade de até 31x também merecem um olhar crítico. O artigo compara contra modelos difusão como o Aurora LM, nunca contra um modelo de linguagem padrão word-by-word. Na geração de texto, o modelo tradicional ainda vence em perplexidade (35,5 contra 83,1 do NCM) e em tradução alemã-inglesa (25,2 contra 22,6). O único domínio onde o NCM demonstra vantagem clara é o Sudoku (que é exatamente o tipo de problema onde o pensamento sequencial é fundamentalmente inadequado). Para quase todas as outras tarefas, modelos padrão seguram o terreno ou vencem, e os testes foram realizados em modelos pequenos (em torno de 100 milhões de parâmetros), não nos modelos de dezenas ou centenas de bilhões que dominam o cenário atual.
Outro ponto crítico é a compressão lossy que NCM introduz ao converter texto em códigos numéricos e de volta. Testes de um utilizador no GitHub mostraram que frases normais mantêm 99,9% do conteúdo intacto após compressão, mas formatos estruturados como JSON e campos separados por pipe caem para míseros 8%. Para quem trabalha com agentes AI (escrevendo caminhos de arquivos, chamadas de API, nomes de funções) isso significa que uma chamada de ferramenta que volta correta 8% do tempo simplesmente falha e força retry loops. O artigo nem testa esse cenário "agente-shaped", focando em dados que não representam o uso real de agentes.
Mas há ainda o cenário local, onde o NCM faz até mais sentido. Executar um modelo de 16 GB em uma RTX 5090 sozinho, sem compartilhamento de leituras de pesos, a banda larga realmente se torna o gargalo. Neste caso, reduzir de 1.024 passes para 32 significa passar de cerca de 9,1 segundos somente em leituras de memória para 0,29 segundos (uma diferença massiva para inferência local em prompts curtos). Mas o "catch" permanece.. é que a capacidade do KV cache cresce com o contexto, e mesmo localmente, modelos de fronteira como o Kim C2.5 (trilhão de parâmetros) exigem 500 GB e apenas nos pesos em precisão de 4 bits, o que está muito além de consumidores atuais, independentemente de como escrevam.
No mercado, a situação é ainda mais complexa. Memórias HBM e DDR5 competem pela mesma capacidade de produção, e as projeções de preço da Trend Force mostram aumentos de 90-95% no Q1, 58-63% no Q2, 13-18% no Q3 e 10-15% no Q4. Isso significa que os custos de RAM podem (e certamente vão) aumentar (apesar de se suspeitar que em 2027 haja uma oferta superior da RAM convencional à procura atual). Seja como for, a possibilidade de demanda por HBM é tão intensa que a SK Hynix já tem acordos de longo prazo cobrindo mais da metade de sua capacidade planejada para 2027-2028. Mesmo que NCM escala, o que muda não é se precisamos de memória, mas que tipo (um data center que precisa de menos bandwidth para leituras de pesos poderia potencialmente mudar para DRAM mais lenta e barata), mas Nvidia já projetou GPUs sem HBM (o Ruben CPX com 128 GB de GDDR7).
Parece pois que o verdadeiro gargalo se deslocou. A memória em servidores de IA não está mais principalmente alimentando o modelo um palavra de cada vez (ela está segurando conversas, históricos de agentes e resultados de "tool calls"). Uma maneira mais rápida de escrever tokens torna o passo de escrita mais barato, mas não faz a "etapa" de lembrar ficar menor. A forma do problema mudou... o passo que o NCM otimiza é agora uma fatia diminuída do trabalho total de memória, enquanto o passo de retenção cresce porque agentes ficam maiores e conversas alongam-se. Da próxima vez que vir um thumbnail com o "Fim da Nvidia" às 1h da manhã (não negue.. eu sei que está acordado a essas horas), a pergunta que faria é: isso faz a escrita ser mais rápida ou faz a exigência de memória ser menor? Porque a grande maioria da memória em sistemas AI atuais não é sobre escrita de jeito algum.
No fim, o NCM é pesquisa genuína e arquitetónica interessante, especialmente para problemas onde o pensamento paralelo supera o sequencial (como o Sudoku). Mas a narrativa de que ele poderia tornar chips de memória desnecessários ou acabar com a dominância da Nvidia baseia-se em uma distorção clara do problema real: o gargalo deslocou-se da escrita para a retenção, e as futuras novas arquitecturas precisarão de atacar a capacidade do KV cache, não apenas a largura de banda das leituras dos pesos. Vale a pena acompanhar a evolução, mas sem expectativas de disrupção imediata, pois provavelmente ficarão decepcionados...