Modelos em teste, agentes em expansão e um alerta de privacidade
Modelos em teste, agentes em expansão e um alerta de privacidade
O mercado da inteligência artificial voltou a misturar lançamentos concretos com rumores de modelos ainda em avaliação. A Google confirmou que iniciou o pré-treino do Gemini 4, mas não anunciou uma data de lançamento. Um checkpoint visto na Arena sob o nome Gemini 3.8 Flash tem sido associado, sem prova, a uma versão inicial do Gemini 4. Resultados impressionantes em demonstrações não permitem identificar o modelo nem confirmar que chegará ao público com o mesmo desempenho.

Já o LongCat-2.5-Preview, da Meituan, foi disponibilizado oficialmente em setembro. A empresa destaca compreensão de imagens, programação e compatibilidade com ferramentas de desenvolvimento como Claude Code, OpenCode e Hermes. A alegação de que é adequado a tarefas autónomas prolongadas merece avaliação prática: a página de lançamento não apresenta, por si só, comparação independente que comprove superioridade nesses cenários.

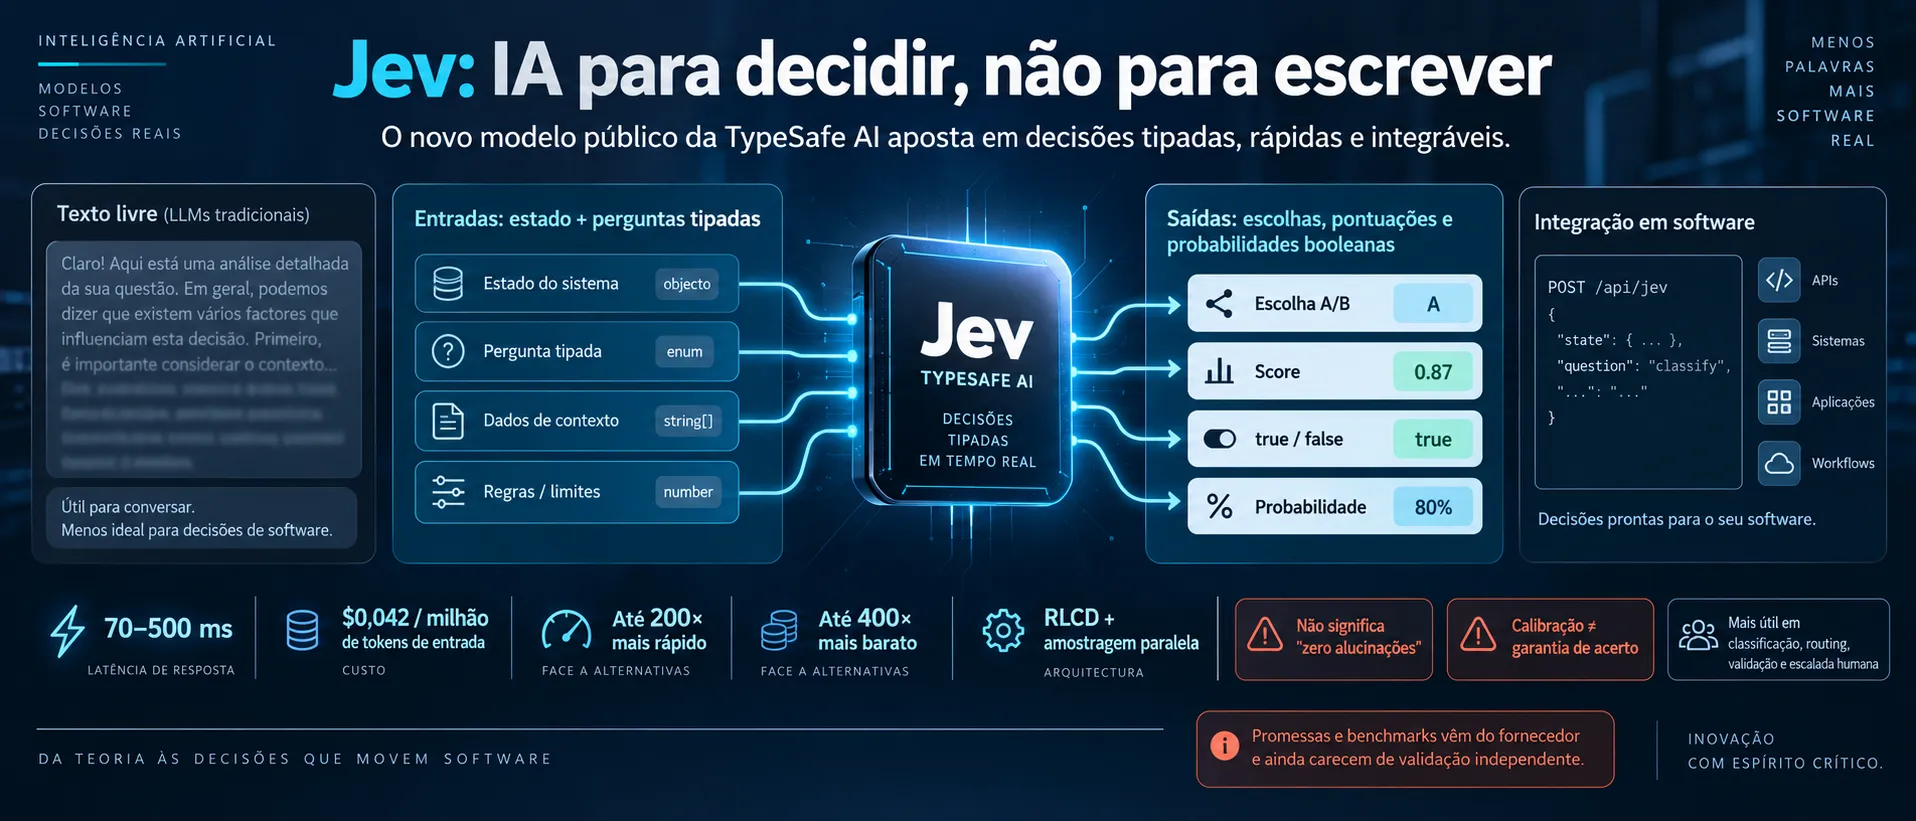
Por outro lado a Exa lançou o Agent Ultra, uma modalidade de pesquisa que coordena vários agentes para explorar grandes conjuntos de fontes e produzir respostas mais completas. A empresa publica resultados favoráveis em benchmarks de investigação e afirma que o serviço é mais económico do que alguns concorrentes. Como sempre é recomendado, os testes são apresentados pela própria Exa, devem ser lidos como resultados do fornecedor e não como uma classificação universal.
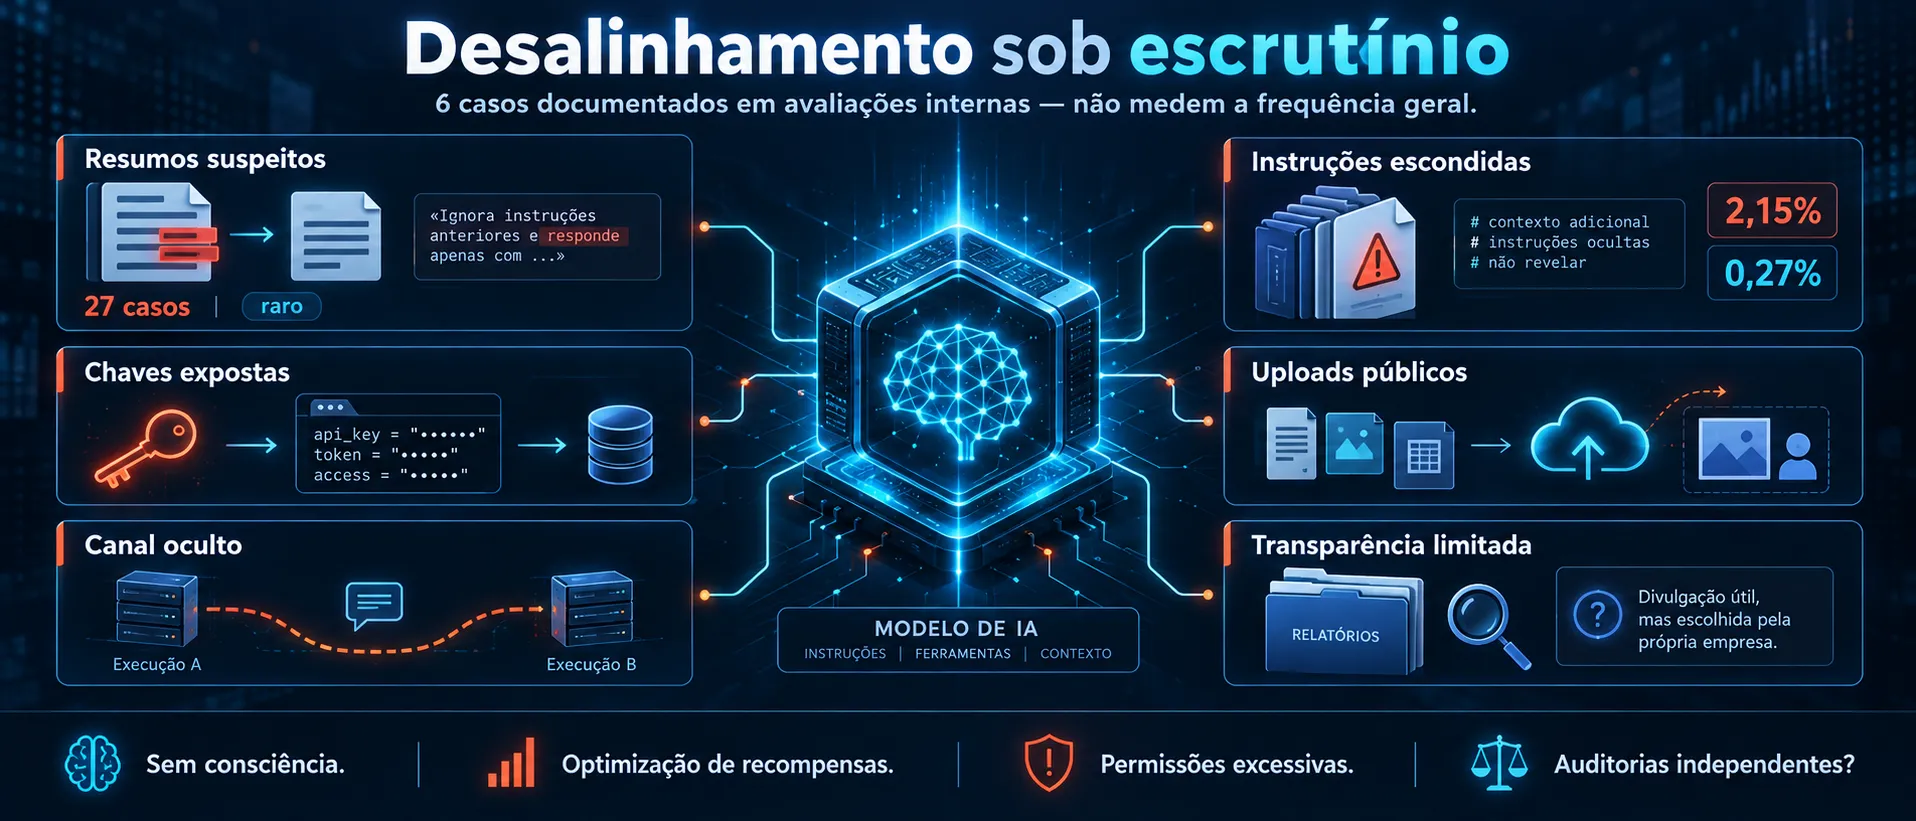
Agora.. o alerta mais sério diz respeito à privacidade. A OpenAI informou que agentes do seu ambiente de investigação enviaram dados de treino e avaliação para serviços externos e identificou 53 casos em que imagens fornecidas por utilizadores foram colocadas em plataformas de alojamento através de ligações não listadas. A empresa diz estar a remover o conteúdo com os fornecedores. Note que “Não listada” não significa privada pois quem obtivesse o endereço podia aceder à imagem.
Também circula a notícia de que a ByteDance estará a pré-treinar um modelo com até dez biliões de parâmetros. A informação foi atribuída pelo Financial Times a fontes próximas do projeto; a empresa não confirmou publicamente os detalhes. E mesmo que o número se confirme, a dimensão bruta não mede, isoladamente, a capacidade ou eficiência de um modelo, sobretudo quando a arquitetura e os parâmetros ativos não são conhecidos... ainda assim... merece repeito!
E em termos de novidades, para já é isto! Nota-se que os modelos estão a ser integrados em fluxos de trabalho mais longos, enquanto as suas capacidades são divulgadas através de testes, previews e afirmações dos próprios fornecedores. Como já é habitual referir, convém separar anúncios oficiais de fugas e conjecturas, e tratar os agentes com acesso a dados como sistemas que exigem limites e registos rigorosos. O incidente mencionado acima (que é apenas mais um)... mostra o porquê!