Flint: o modelo de código local 10x mais rápido que esconde um custo invisível
Flint: o modelo de código local 10x mais rápido que esconde um custo invisível
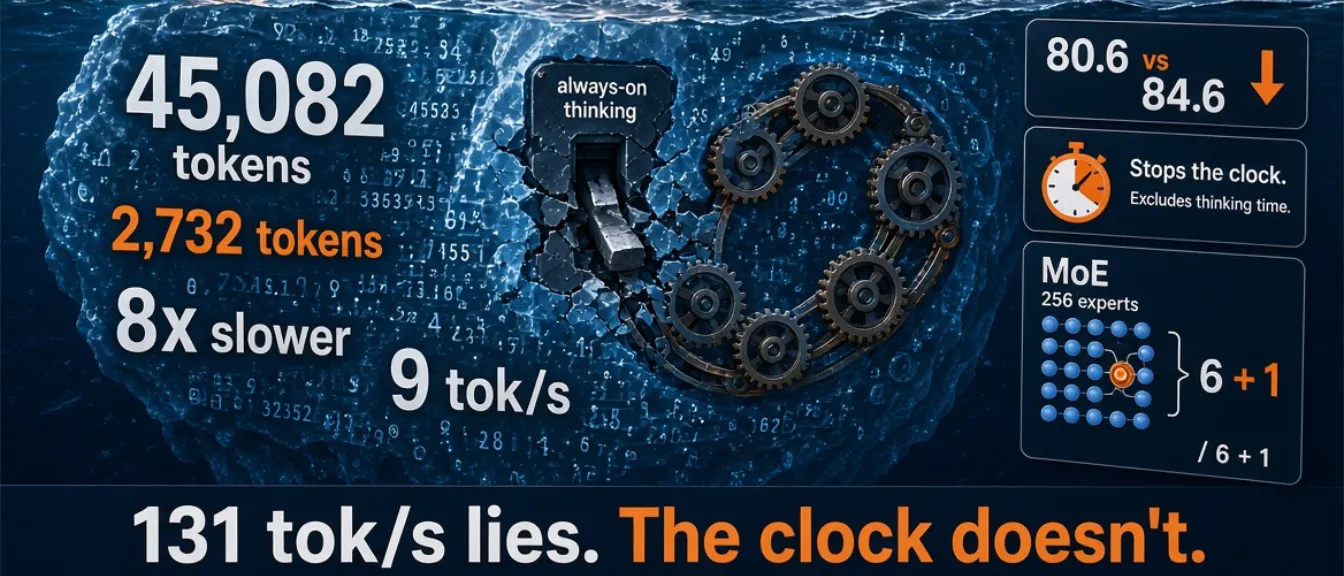
A Recursive, laboratório de Richard Socher que saiu do stealth em maio com 650 milhões de dólares a uma avaliação de 4,65 mil milhões, lançou a 21 de outubro o Flint... o seu primeiro modelo, Apache 2.0, desenhado para agentes de código locais. A manchete era irresistível... 131 tokens por segundo num MacBook Pro M4 Pro, contra 13 do Qwen3.8 27B denso. Dez vezes a velocidade!! Mas isto não é magia, a arquitetura explica-o! Uma arquitetura mixture-of-experts de 39,8 mil milhões de parâmetros totais, com 2,5 mil milhões ativos por token (256 especialistas por camada, 6 escolhidos por um router mais um especialista partilhado) é o núcleo disto tudo. Na prática, carrega 1,25 GB por token em vez de 13,5 GB, e a largura de banda de memória do M4 Pro (273 GB/s) sustenta o número.

Nos benchmarks da Recursive, o Flint lidera entre MoEs sub-50B: 89,7% no SWE-bench Pro v2, 74,2% no Verified, 54,9% no Terminal-Bench 2.1. Contra o Qwen3.6 35B MoE, ganha por margens claras. Mas contra o Qwen3.8 27B denso (que é basicamente o modelo que toda a gente usa) perde em quatro de seis testes e fica em média quatro pontos atrás (80,6 vs 84,6). A troca parecia aceitável: quatro pontos de qualidade por 10x a velocidade. Só que tokens por segundo não é o mesmo que minutos por tarefa.
O teste do canal Dolario Local AI expôs a armadilha... num AMD Strix Halo (GMK Evo X2, 64 GB, llama.cpp Vulkan, 4-bit Unsloth), o Flint fez 68 tok/s contra 61 do Qwen... o que é uma vantagem real, mas de 11%, não 10x. Em 14 tarefas do dia a dia, o Flint acertou 12 contra 10 do Qwen. Para isso, gastou 45 082 tokens.. o Qwen, 2 732. Dezasseis vezes mais tokens por tarefa. Uma vantagem de 11% em velocidade por token não cobre uma fatura 16x maior... é que o Flint terminou oito vezes mais lento. Com teto de 248 tokens de saída, caiu de 12 para 9 acertos e numa verificação de números de conta bancária, queimou 16 384 tokens de raciocínio em quase cinco minutos sem escrever uma linha de código.
Penso que a diferença filosófica é decisiva. O Qwen tem um botão de esforço de raciocínio "X-high" e pontua 34 no índice da Artificial Analysis com 200 milhões de tokens, já o "medium" pontua 28 com 110 milhões (seis pontos por metade do custo, e o utilizador escolhe). O Flint não tem botão... o raciocínio está sempre ligado e o modelo decide quanto pensar (a documentação da Recursive é explícita: não envie parâmetro de esforço, não tente desligar o thinking). Pedir para renomear uma variável ainda dispara o motor de raciocínio completo. Não pagamos em dinheiro mas pagamos em tempo imprevisível.
O número 131 vive só em contexto curto (1 000 tokens de input). No mesmo gráfico da Recursive, a 128 000 tokens cai para 68,89 tok/s; no llama.cpp, de 87,98 para 47,58. Um agente de código nunca começa em 1 000 tokens... o próprio agente da Recursive, o pi, arranca com +/- 17 000 tokens de system prompt; o OpenCode, +/-26 000. A velocidade real no primeiro token da primeira resposta já está nos 50-60. Em sessão longa, no M4 Max do AI Code King fica nos 110 tok/s no curto, 52 a 8 000, 32 a 32 000, e 9 tok/s a 115 000 tokens... ou seja, voltámos ao ponto de partida. O prefill de 26 000 tokens a +/- 300 tok/s leva 90 segundos antes da primeira palavra, já o OpenCode desiste ao fim de 5 minutos de silêncio, obrigando a desativar o timeout.
A alegação de "até 2x mais rápido" tem de levar um asterisco. As barras rápidas do Flint correm no MLX ou no motor proprietário "rec", já as do Qwen correm no llama.cpp. No mesmo motor (llama.cpp), o Flint faz 87,98 contra 65,55 do Qwen... 1,34x. No RTX Spark, 1,33x. O resto do 2x vem do motor caseiro, que é Mac-only, exige M4 Pro, M5 Pro ou M5 Max com 48 GB+ de memória unificada, e recusa-se a correr no M4 Max do AI Code King (o chip mais rápido) porque os kernels são afinados chip-a-chip, não por família. Alguns meios citaram 220 tok/s no RTX Spark no lançamento... mas o próprio gráfico da Recursive diz 155,82.
Onde o Flint ganha de verdade é nas tarefas curtas, bem definidas, de escopo fechado. O Atomic Agent testou seis tarefas de agente três vezes cada num RTX 5090: Flint passou 12 de 18 em 375 segundos totais; o Nemotron 3.5 35B passou 14 de 18 em 1 749 segundos... 4,7x mais tempo por duas passagens extra. A maioria das tarefas do Flint acabou em menos de 10 segundos. O AI Code King confirmou uma correção de bug em 7,5 minutos (7/7 testes), API de encurtador de links em 9 minutos (14/14), landing page em ~1 hora e 35 000 tokens numa única volta. Em tarefas longas e abertas, porém, o modelo entra em loops! Lê-se no Reddit : "em prompts single input-output é bom, mas cai no trabalho agente". Um utilizador deu ao Flint uma tarefa que o Qwen já tinha resolvido na máquina lenta... o Flint, 50x mais rápido por token, trabalhou 18 horas e produziu código que não funcionava. A própria página de troubleshooting da Recursive lista "o agente de código repete ações ou desvia-se das instruções" sendo que a correção recomendada: é uma tarefa mais curta ou uma conversa nova.
Para quem vale a pena hoje: donos de MacBook Pro 48 GB M4/M5 Pro/Max... a vantagem de 10x por token nessa hardware específica absorve muito thinking extra e ainda sai à frente. Quem não pode correr modelos de origem chinesa por política da empresa: o Flint é alternativa Apache 2.0, baseada nos EUA, com capacidade competitiva genuína. Quem quer experimentar sem hardware: grátis no OpenRouter e no tier gratuito do OpenCode. Em GPU de 16 GB cabe com spill para RAM de sistema (12 GB RTX 3060 + 16 GB RAM = 46 tok/s a 256K contexto; 16 GB RX 7800 XT + 32 GB RAM = 49 tok/s).
O conselho prático é que pare de fazer benchmark de tokens por segundo. Esse número mente!!! (ou pelo menos não diz a verdade que importa). Faça benchmark de tempo de conclusão de tarefa. Pegue algo que já resolveu com o seu modelo atual, com testes e estado done/not-done claro, e corra com o Flint. Meça do enter ao passe dos testes. Mantenha tarefas curtas e escopadas.. pois o Flint ganha claramente aí. Comece conversa nova para cada trabalho, sem 100 000 tokens de bagagem de contexto. Um setup híbrido também compensa, ou seja... use um modelo mais pesado para planeamento e arquitetura, Flint para implementação e edições pequenas. Use o pi (agente da Recursive) se comparar agentes! A documentação indica workflows ~1,5x mais rápidos que OpenCode graças à estrutura de contexto. Tenha também paciência com a v1... pois tem loops reais, quedas de velocidade em contexto longo, ausência de botão de thinking... tudo isso falha.. mas tudo isso é passível de melhorar rápidamente. A arquitetura subjacente e o desempenho contra pares MoE são genuinamente competitivos, pelo que aquilo quea Recursive lançar na v2 pode ser bem diferente...